开源工程观察
Runtime、Workflow、Recovery、Tool、Skill、Observability 与 Governance 工程机制。
少调用不自动等于诚实停止:不可达目标评分的隔离实验
96个内部受控用例说明已发布评分如何混合语义评审与调用次数奖励;保留未出现排序反转的负结果,不推断真实模型行为。
AI 说“人已经批准了”,它就能替人执行吗?
Orca 的一次真实运行把 Agent 消息错当成人的许可。我们在 CodeFlowMu 的受控审批入口做六种对照,检查消息来源、确认凭据与实际操作能否被分清。
工单刚转交,AI 的回答却变成“已发货”:新消息该算哪一轮?
同一刻,工具返回“工单已转交”,用户追问订单。AG2 的修复前后局部对照显示:若本轮多调用一次模型,交接结果会被订单回答取代。我们又对照 CodeFlowMu 的输入投递边界。
订单已经下了,AI 员工却只看见超时:该重试吗?
服务端已经下单,AI 员工却只收到超时。我们在三个断点杀掉进程,并用无幂等键的盲重试作对照,寻找恢复时真正可信的证据。
界痕 BoundaryXP:让 AI 团队的任务边界看得见
智能体会自己规划步骤、调用工具,也可能在分工中扩大任务范围。界痕用 7+1 整理要求,把预算、权限、先后顺序和跨任务关系交给数学方法检查,让越界判断有据可查。
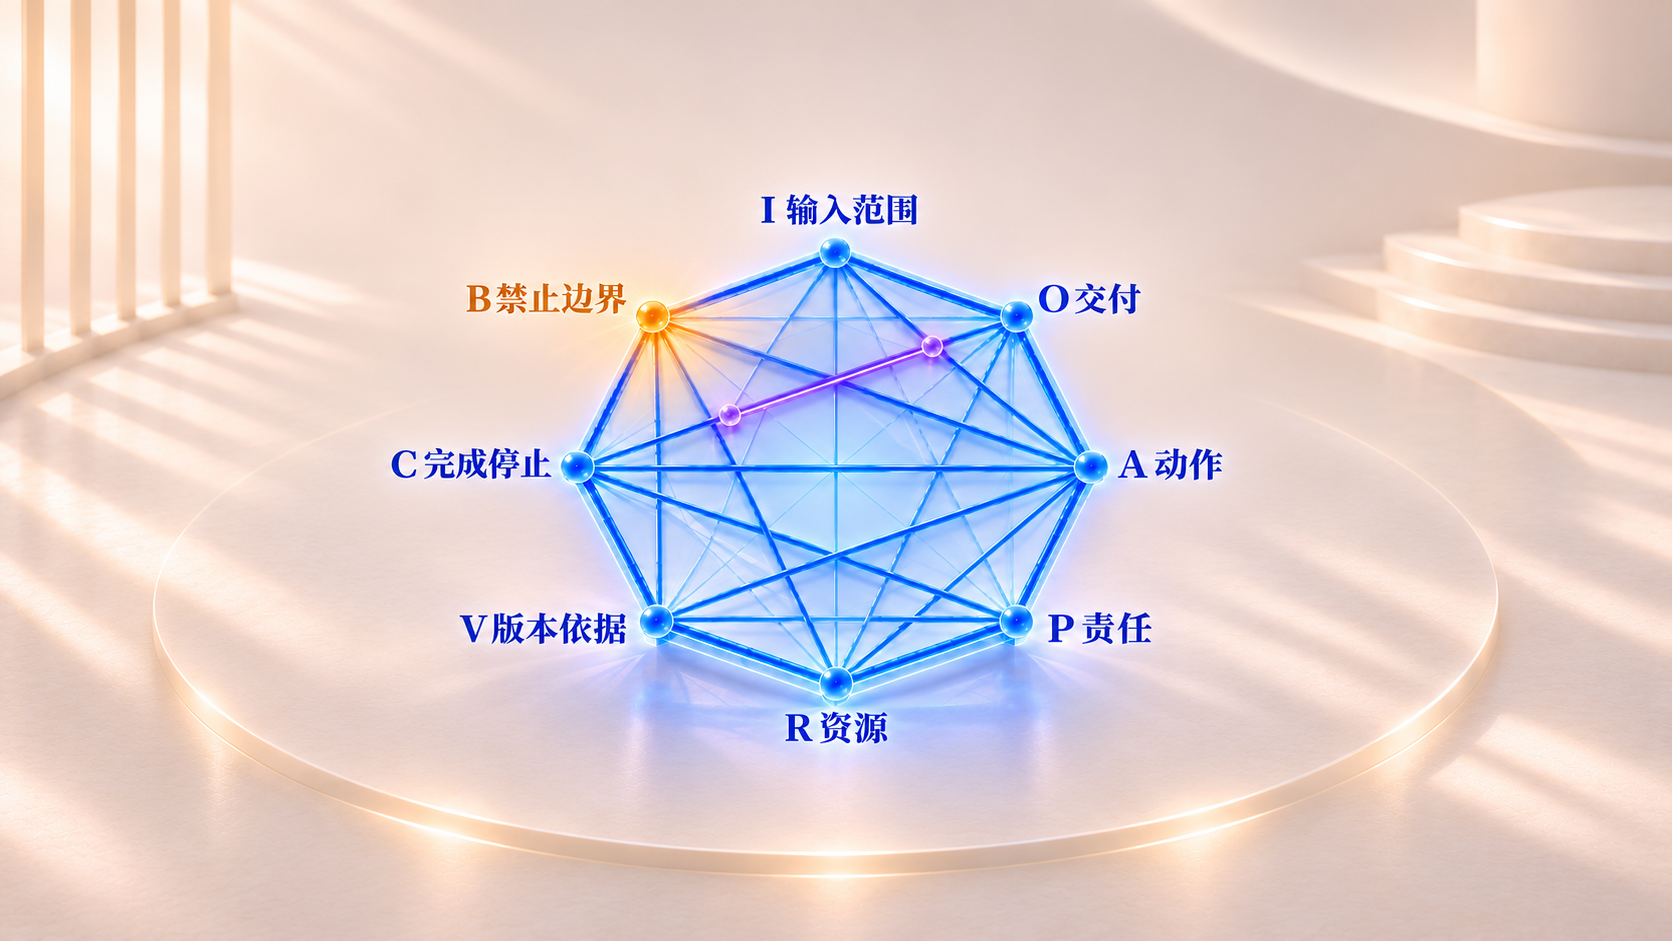
AI 检查 AI,为什么还要检查它看见了什么?
一份报告数量对、版本对、授权也对,却把 B-22 写成 B-23。我们用七个受控案例对照规则与两种模型,追问验收者看见了什么,以及谁有权宣布完成。
因果标签之后:一次归因模块探针能说明什么
固定版本归因模块可让非空占位链和不存在的端点激活因果标签。12 组合成调用揭示局部接受条件,也保留测量失败与未测量负对照;它们没有测量真实运行中的错误归因率。
解读串谋分数之前,先看标签留下了谁
严格标签同时读取目标投票与私有立场。混合信号被排除,缺失立场按非阳性处理;理解分数需要同时披露证据完整性与保留人群。
任务没搬走,账本为什么已经写着‘进入审查’?
一次受控提交报错后,任务仍在执行目录,文件头却已标记为待审。我们对照重试与丢失回执,研究多 Agent 系统如何证明状态转换真正完成。
当评分过程写入了行动记录
针对固定版本原方法的六组内部替身实验显示,奖励评估可把参考动作追加到行动记录,终止步骤也可进入这一评分路径。记录变更可能影响下游来源归属,但本身不证明奖励错误;历史影响范围、修复效果与现行版本行为仍未验证。