开场白为什么成了交付结果?
“我来检查一下。”
如果同事只回复这句话,你大概会继续等。可在一次开源 AI 调度工具的故障中,这类开场文字竟然进入了结果文件,成了等待交付的“成果”。
更反常的是,AI 服务已经报告了错误。负责收集结果的程序却看见了一个看起来很让人放心的信号:正常退出。
这是 anywhere-agents 作者报告的问题。这个工具负责把工作交给不同的 AI 编程助手,再收集它们的输出。我们受到其修复启发,拿原始调度脚本做了前后对照,想弄清楚:任务没有完成,为什么负责收尾的程序却没拦住?
我们会留意这个问题,是因为自己也在开发 CodeFlowMu,一个多 AI 助手协作系统。交接工作时,后续环节需要知道前一环留下的是可验收的结果,还是一段未完成工作的输出。这个来源把难题缩小到了一个具体冲突:退出码说正常,服务回应却说失败。它还提供了修复前后的代码和测试,适合拿来验证究竟是哪一个判断出了错,而不是只凭经验提醒“记得检查结果”。
它看见了文字,却看错了“成功”
一次 AI 调用里,往往有不止一个程序在传递消息。外面的调度程序启动命令行工具;命令行工具联系 AI 服务,再把服务的回应传回来。
命令行工具结束时,会留下一个数字,叫退出码。通常,0 表示正常结束。但调度程序如果只看这个数字,就可能漏掉回应里更具体的坏消息。
Yue Zhao 的这次修复针对的就是这种错位:Agy 遇到额度限制,最终事件标着 ERROR(错误),还附有模型的开场文字,进程却返回了 0。旧调度器沿着“退出正常、文字非空”的路径,把文字写进结果文件。
于是,真正的问题被两件看似正常的事遮住了:程序结束了,也确实有文字。
这给了我们一个可以单独验证的问题:保持退出码为 0,只让回应明确带上错误,调度器还能认出来吗?
让旧程序和修复后的程序,读同一份坏消息
我们使用项目原有的测试工具模拟 AI 回应,让两个版本的调度脚本处理相同场景。脚本启动、事件读取和临时文件写入都在本地真实执行;AI 服务的回应由测试替身提供,便于准确控制输入。
五组对照中,有三组故意制造错误,另两组检查正常行为和旧格式兼容是否保留:
| 交给调度器的场景 | 旧版判断是否符合预期 | 修复后 |
|---|---|---|
| 退出 0,但回应报错并附开场文字 | 不符合 | 正确报告失败,并留下后备处理标记 |
| 回应报错,但执行助手已经写了结果文件 | 不符合 | 保留文件,同时报告运行失败 |
| 先收到错误,后收到一条没有状态的结果消息 | 不符合 | 保留先前的错误判断 |
| 回应明确标为成功,并附结果文字 | 符合 | 仍然符合 |
| 回应有文字,但没有状态字段 | 符合旧版兼容规则 | 仍保留兼容通过 |
前三组在旧版都没通过测试,修复后都通过了。这里“通过”的意思恰好是:程序终于能够正确承认失败。
最后一行也很重要。修复没有把所有缺少状态的旧格式都判成错误;它仍允许兼容通过。因此,“明确成功”和“没有状态但被允许继续”是两种不同的证据,不能混成一句“AI 已经确认完成”。
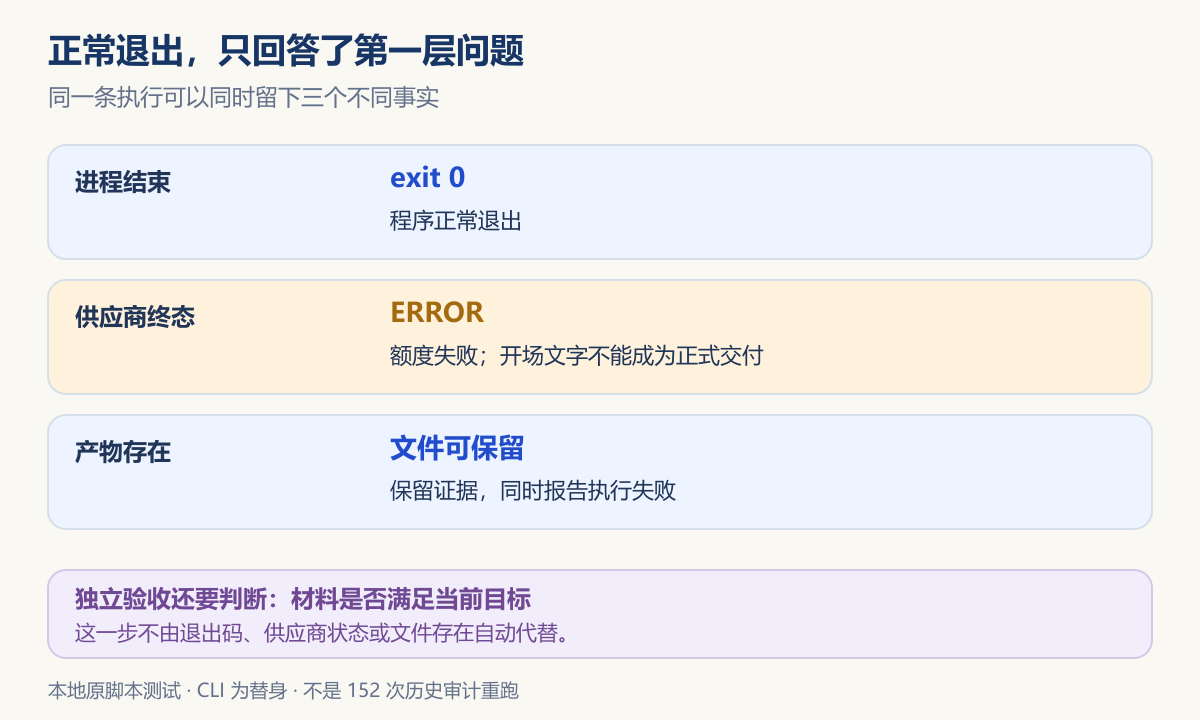
图 1:同一次运行可以留下不同层次的结果。来源:本轮 runs/dispatch.json 与原始测试日志;AI 服务事件由测试工具模拟。
既然失败了,为什么还要留着文件?
第二组实验比“识别错误”多问了一步:如果 AI 助手已经写了文件,后来才遇到错误,该怎么办?
一删了之,会丢掉已经完成的工作;直接当成交付,又可能把半成品送出去。修复后的程序选择同时保留两个事实:文件还在,这次运行失败了。
这并不矛盾。对接手的人或程序来说,“有东西可以检查”很有用,但检查之后才知道它是否满足任务要求。文件存在,只回答有没有材料;它没有回答材料是否正确、完整。
第三组实验还揭示了一个容易漏掉的细节:最后一条消息不一定最完整。前一条明确报错,后一条没写状态,后者不该把错误擦掉。修复后的解析器分别保留最近提供的状态、错误和文字,避免用缺失字段覆盖已有信息。
这两处改变,都让调度器少做了一次没有依据的推定。
看见“完成”时,可以多问哪几句?
这项实验带给我们的启发,是把一个笼统的“完成”拆开检查:
- 执行有没有成功? 除了外层程序的退出码,还要看 AI 服务是否明确报错。
- 留下的是什么? 开场文字、处理中间记录和正式结果,不能只按“非空”归为一类。
- 结果满足要求了吗? 即使运行成功、文件也在,仍要核对用户要的内容是否做完。
对使用者来说,如果“完成”后看到的只有“接下来我会……”,就有理由继续核查。对开发者来说,值得把上面的坏消息、残留文件和缺失状态输入放进测试,观察自己的收尾程序会怎样判断。
我们还留下了一个交流问题:对于兼容通过的旧回应,能否让后续检查知道它缺少明确的成功状态?这是实验引出的设计问题,还不是已证明的新缺陷,也没有据此确认 CodeFlowMu 存在同样的问题。 这个追问来自对照表的最后两行:明确成功和缺少状态,在受测路径中都能继续流转,但依据并不相同。如果后续验收只看到“通过”,它还能分辨两者吗?下一步值得检查的是这一区别能否传递到真正使用结果的地方,以及它是否应影响验收方式;本轮实验尚未回答这些问题。
延伸阅读:先检查额度,能避免这种失败吗?
后续的额度路由改动在派发任务前读取各模型组的额度快照。Claude/GPT 组耗尽时可以转向 Gemini;Gemini 耗尽时,不自动反向切换到较稀缺的模型组。实际选择和后备处理说明会被记录。
我们跑了七项原额度策略单测,覆盖最紧额度桶、非有限数值、刷新失败后的旧快照、重置时间、未报告模型组、模型名分组与关闭检查,均通过;另有四项辅助检查通过。它们使用临时缓存与测试替身,没有测量真实额度、费用或吞吐量。
一个模型组没出现在快照里时,程序仍允许尝试。这表示情况未知,不能当成已确认可用。提前检查有助于选择执行路径,但任务能不能出发,与最终有没有完成,仍要分别判断。
实验范围与复现。 本文验证的是固定源码如何解释指定输入。作者报告的 152 次历史派发审计没有由我们重跑,也没有在真实服务中耗尽额度;测试不覆盖任意事件乱序和重放。五组前后对照、额度单测、版本与原始日志见实验材料,完整材料保存在研究仓库。
你有没有遇到过:工具显示“完成”,打开结果却发现它还停在“准备开始”?当时是哪一个细节让你发现不对?如果你正在开发这类工具,也欢迎分享你如何区分“明确成功”和“兼容通过”,尤其是这一区别在后续验收中有没有实际用途。