Agent 不是权限边界:跨载体失效揭示了什么
两次 Agent 执行,最后可以得到完全相同的文件。
它们可以呈现相同的 Git diff、相同的可见记忆、相同的候选制品。一个应该发布,另一个却必须阻断。
如果这听起来互相矛盾,真正缺失的事实根本不在文件里。
论文 Beyond Agent Harnesses: Cross-Substrate Authority for Multi-Agent Systems 于 2026 年 9 月 8 日首次提交 arXiv,研究的正是这种情况。它提出,多 Agent 系统会出现一种 cross-substrate authority gap(跨载体权限缺口):规划 Agent 看见的是工作区和记忆状态,而真正决定某个下游效果是否允许发生的授权状态,却可能存在于另一个 Runtime、注册表或审批服务中。
这个区别很容易被忽略,因为现代 Agent 系统很擅长把一切都变成“上下文”。策略可以写进 system prompt,审批结果可以摘要进记忆,共享文件也可以写着“是谁修改的”。但这些表示都不必然证明:
此刻这个 actor,在这一次 execution attempt 中,仍被授权针对这些字节、这个 consumer scope,产生这个具体效果。
因此,真正的权限边界可能并不在模型会话本身。
字节完全一样,正确动作却可以相反
论文构造了一个刻意令人不舒服的场景。
两个 coding agents 修改同一个共享策略文件及其消费者。在两个世界里,下游 Agent 看到的最终文件逐字节相同,未提交的 Git 证据相同,可见记忆也相同。
在 aligned world 中,每个写入者都对自己的 scope 拥有授权,因此可以发布。
在 crossed world 中,两个写入者被交换到了错误的 scope。最终字节碰巧仍然一样,但制品必须停止发布并进入协调。
规划器看到的观察完全相同,正确动作却改变了。
作者把它形式化为 observation aliasing:如果世界 x 和 y 暴露相同观察 O,但一个要求 publish、另一个要求 block,那么只看到 O 的确定性策略必然在两个世界输出同一个动作,因此至少有一个世界会错。永远阻断可以避免不安全发布,却会在真正已授权的世界制造不必要阻断。
这首先不是“模型不够聪明”。
它是一个信息边界问题。
如果区分两个世界的关键事实根本不在观察里,再强的推理也无法从同一份观察中凭空恢复这个缺失事实。
权限不是“这个 Agent 有权限”这么简单
常见表达是:这个 Agent 有没有权限?
这往往太粗。
论文使用的 decision relation 把多项事实绑在一起:actor 与 attempt 身份、session 与 consumer scope、输入和制品哈希、被授权的动作范围、attempt 的终态、下游使用授权,以及 evidence generation。
重点在于“关系”。
不是:
    agent_A = authorized

而更接近:
    actor A
    + attempt 17
    + artifact hash H
    + consumer scope S
    + action "publish"
    + terminal state
    + downstream authorization
    + evidence generation G
    = admissible relation
同一个 Agent 可能对一个 scope 有权,对另一个 scope 无权。同一份字节,在一种执行谱系下可以发布,在另一种谱系下必须阻断。先前有效的审批,也可能在工作区变化或授权 generation 更新以后变成陈旧证据。
所以,“这个 Agent 当时有权限”并不是一条足够强的审计事实,除非这个权限真正绑定到了后来发生的那次动作。
论文实际上拆开了三个问题
这篇论文一个很重要的价值,是没有把“让模型看到权限”和“真正执行权限”当成同一种机制。
三个实验形成了一条很清楚的链。
实验一:先把缺失的权限事实补进来
实验一交叉组合四个 held-out semantic templates、两个模型路由、两个 lineage directions、两种外部发布状态和四种 evidence arms,共形成 32 个 matched strata、128 个目标执行。
作者报告:
- Git-only control
G0:最终语义成功 0/32 - 有候选制品但缺权限事实的
C0:0/32 - 加入 canonical raw authority receipts 的
R0:32/32 - 把同一组 admitted primitives 包装成 typed relation 的
W0:32/32
这些数字都是论文作者报告的结果;本次 Academic 运行没有独立复现实验。
这里最值得保留的解释不是“typed governance 已经解决问题”。真正有识别力的是 R0 与 C0 的对照:补上缺失的外部权限事实以后,论文构造的歧义被解除。至于 typed W0,在这个实验中并没有显示出比等量 raw authority information 更高的最终语义正确率。
先重要的是信息本身,然后才是包装形式。
实验二:模型看到了,规划仍然不可靠
实验二进一步问:面对 observation-equivalent 的共享工作区,规划 Agent 能不能安全决定是否发布?
论文一共执行 96 次 planning calls,报告普通工作区证据、raw receipts 和 typed relation 三个条件下的 first-action correctness 分别为 14/32、19/32、15/32。
在 crossed worlds 中,不安全发布分别为 12/16、9/16、6/16。
但最后这个 6/16 不能简单理解成“大幅变安全”,因为 typed relation 条件同时出现了 11/32 个 invalid or absent outputs。模型拆分结果更说明问题:一个路由看起来几乎不做不安全发布,却有很多行根本没有形成有效意图;另一个路由能正常解析 relation,却仍会在多个 crossed cases 中提出不安全发布。
因此,一个总的“安全分”会掩盖问题。
规划器可能因为真正理解规则而保守,也可能因为根本没有正常行动而显得保守。安全效果率、正确动作率、不必要阻断率、缺失意图率,是不同的指标。
实验三:把模型意图固定住
第三个实验对系统架构最有启发。
研究者直接拿实验二 typed-relation 条件下已经生成的 32 个 first-action intents重放,不再调用模型。模型没有第二次思考机会,唯一变化是执行时 validator。
论文报告,这 32 个固定意图中包含 6 个 crossed-world 的不安全发布请求。加入 execution guard 后,这 6 个全部变成 safe non-effects;与此同时,12/12 个有效且已授权的 publish intents全部被允许,在这个 valid-intent 集合中出现 0/12 的误拒绝。
模型的意图没有变,最终效果变了。
这就是最关键的区别。
让模型看到权限,与真正拥有效果权限,是两层
Prompt 可以明确写:
只有当前 actor 对制品 scope 有权限时才能发布。
模型可以读懂这条规则,甚至可以一字不差地复述。
但 prompt 仍然属于规划器的观察。它本身并不能保证最终效果边界一定执行这条规则。
论文的实验支持一种两层结构:
规划阶段:
    暴露权限证据
    让模型理解、推理、解释

执行阶段:
    校验 actor / attempt / artifact / scope 关系
    重新检查策略相关字节
    决定 mutation 是否真正发生
第一层提高判断质量。
第二层决定提议是否变成效果。
这并不是反对 Agent 智能,而是给 Agent 智能划出一个它不需要冒充的边界。
Research Center 综合:四种载体,最后才跨过一个效果边界
下面这张图是 Research Center 综合模型,不是论文图的复刻,也不是论文作者声称已经标准化的架构。
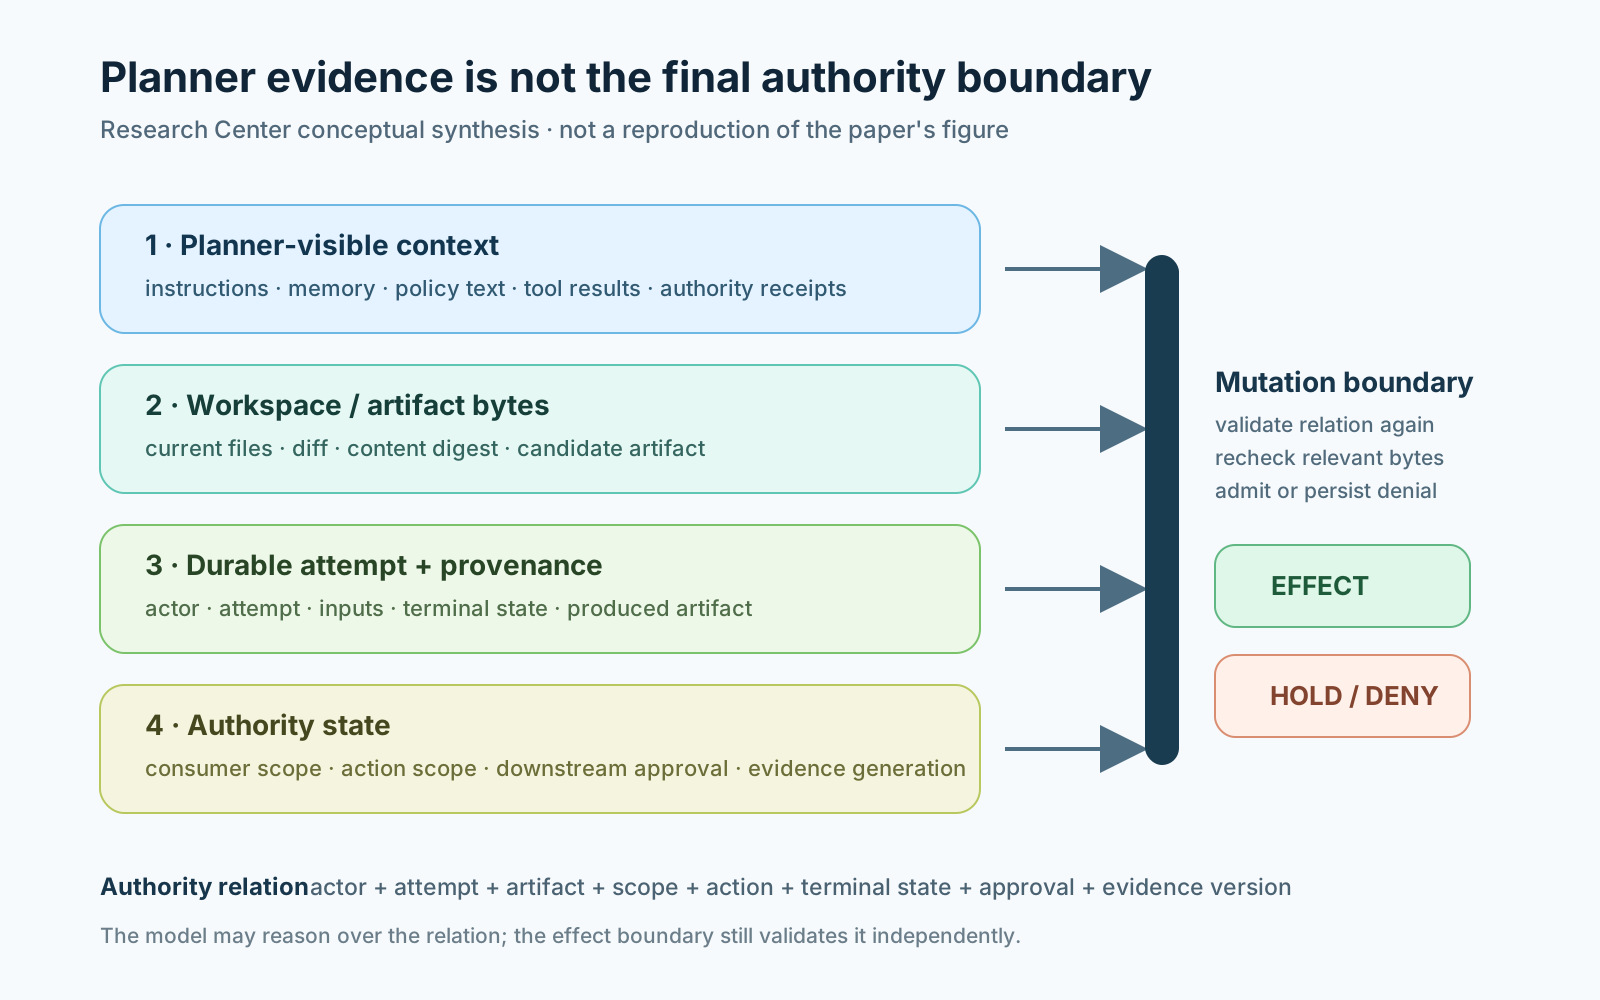
一个生产系统可以把状态至少拆成四种载体。
1. Planner-visible context
这是模型可以直接推理的世界:任务指令、记忆、检索事实、策略文本、工具返回,也可以包括权限回执。
它负责支持判断。
2. Workspace / artifact bytes
它回答另一个问题:当前究竟有哪些材料?
内容哈希可以证明“当时看到的是哪些字节”,却不必然证明“谁被授权生产或发布这些字节”。
3. Durable attempt / provenance state
它把材料绑定到一次具体执行:哪一次 attempt 运行过、是否已经终态、使用了什么输入、生成了什么 artifact。
如果缺少这一层,共享工作区很容易抹掉“这些材料到底是哪次执行产生的”这条关系。
4. Authority state
它回答:当前这个 actor-attempt-artifact-scope 关系,是否仍然被允许跨入下游效果?
真正的 mutation boundary 应消费这条可验证关系,而不是从聊天摘要里猜测它。
因此可以得到一个简单原则:
权限证据可以提前进入模型上下文,但权限本身必须一直活到动作真正产生效果的那一刻。
Git 可以足够——前提是 Git 真的承载完整权限关系
这篇论文不应该被概括成“Git 不够”。
作者明确保留了一个重要的 negative control:如果经过认证的 commit 已经绑定了 actor、attempt、scope、artifact,而且这些 Git 元数据本身就是下游使用的权威依据,那么 Git 可以承担权限边界。
只有当某些必需事实仍然存在于 Git/工作区之外时,才出现 cross-substrate governance 的必要性,例如:外部审批服务、任务 Runtime、撤销注册表、可变化的 evidence generation,或者尚未提交的共享工作区 provenance。
所以更好的问题不是:
Git 还是 Agentic OS?
而是:
权威关系究竟存在在哪里?下游效果能不能不靠猜测就验证它?
这个问题更有普遍性。
“工作完成”与“允许下游使用”不是一回事
论文 decision relation 里还有一个很值得注意的分离:attempt terminal state 与 downstream-use authorization 是两项不同事实。
一个 Agent 可以成功完成任务,但输出尚未被允许公开发布。
一个 artifact 可以已经通过审核,但工作区随后发生变化,使原来的批准失效。
同一份可发布内容,也可能因为执行发布动作的 actor 改变而必须重新判断权限。
如果把这些状态都压成一个 done=true,正好会制造论文希望揭示的那类歧义。
对于持久化 Agent 工作,至少应该分别回答:
工作完成了吗?
哪一次 attempt 产生了这些字节?
现在还是同一份字节吗?
下游使用得到批准了吗?
批准的是哪个 actor 和 scope?
这个批准现在仍有效吗?
生命周期状态只能回答其中一部分。
这不是一个完整的安全模型
证据边界必须保持清楚。
论文是在两个四模板 family、两个模型 route 上做的受控 mini-benchmark。实验三只是重放 32 个先前已经生成的 intents。作者自己明确指出,真实部署中的发生频率需要另一套采样设计。
研究还假设 host 非恶意、actor credential 真实、authority database 未被攻破、哈希抗碰撞。
它没有解决:
- 恶意 host;
- actor credential 被盗;
- 大规模密码学身份;
- 多租户策略组合;
- 语义业务裁决;
- 所有并发和恢复故障。
因此最稳妥的结论是一个机制结论:
当权限状态对决策关键、但存在于 planner-visible substrate 之外时,让模型看到权限事实有助于解除信息歧义;而若希望下游效果可靠,仍然需要一个独立可验证的执行边界。
这个结论已经足够重要,不需要被扩大成“完整安全方案”。
安全性与可用性应该分别计量
规划实验还有一个很实际的测量启示。
一个拒绝所有动作的系统可以做到零不安全发布,但它没有生产价值。
一个在困难场景里经常生成不了有效动作的模型,也可能在某个分母上看起来“更安全”,同时可用性已经很差。
因此生产监控至少应拆开:
- unsafe effects;
- 已授权有效效果的放行率;
- unnecessary blocks;
- invalid / missing intents;
- stale-evidence denials;
- recovery-required cases。
这比一个总的“Agent 安全分”健康得多。
也只有这样,规划质量与执行门禁才能被独立改进。
给数字员工系统的一条实用规则
不采用任何特定“Agent OS”概念,也可以提炼出一条很直接的规则:
不要把 Agent 会话本身当作“效果已经被授权”的证明。
模型当然应该读取证据、提出动作、解释为什么它认为一次发布、数据库写入、handoff 或外部调用是合理的。
但在真正跨过 consequential mutation 之前,系统还要回答一个更精确的问题:
当前经过验证的关系,是否仍然授权这个 actor、这次 attempt、这份 artifact、这个 action、这个 consumer scope,以及这个 evidence version?
如果这个问题无法被证明,系统应该把不确定性保留成 Blocked 或 reconciliation,而不是从上下文中“生成”出权限。
这不是不信任模型。
而是承认:推理与授权,本来就是两份工作。
还有哪些问题没有解决
下一步的问题并不小。
跨组织的 authority relation 应该怎样表示?Artifact 已经 handoff 以后,撤销如何传播?什么条件下 signed Git commit 可以替代外部 registry?哪些谓词适合确定性检查,哪些仍然需要人或模型裁决?Runtime 恢复以后,怎样证明上一次外部效果究竟发生了没有?Authority store 自己又如何被审计和复制?
这些问题超出了当前论文的固定实验。
但这项研究至少让一种常见设计更难再被忽略:
一个上下文完整、逻辑自洽的模型会话,并不自动等于最终权限边界。
Agent 可以知道。
工作区可以一致。
计划可以合理。
最后那个效果,仍然可能没有被授权。
来源与证据边界
- Yang Li, Sergey Volkov, Hai Liu, Zongsi Xu, Xiyu Chen, Tuo Zhou, Dian Shao, Hao Sun, Ye Lu,Beyond Agent Harnesses: Cross-Substrate Authority for Multi-Agent Systems,arXiv:2609.08472,首次提交于 2026-09-08 — https://arxiv.org/abs/2609.08472
- 论文 HTML 全文 — https://arxiv.org/html/2609.08472
- Brian Jin,Fresh Context Is Not Enough: An Agent Action Needs a Valid Chain Back to Its Decision,DEV Community,2026-09-11 — https://dev.to/kikashy/fresh-context-is-not-enough-an-agent-action-needs-a-valid-chain-back-to-its-decision-1afk
- 受治理 Deep Reading —
research/reading/A-20260916-01-cross-substrate-authority.md - 受治理 Research Analysis —
research/analysis/A-20260916-01-cross-substrate-authority.md
**证据边界:**本次 Academic 对象以 arXiv 论文为一手证据。全部实验数字均按论文作者报告处理,本次运行未做独立复现。四载体模型以及“权限是一条必须持续到 mutation boundary 的关系”属于 Research Center 综合;DEV Community 文章属于二手语境材料,不是独立实验复现。